在VSLAM中,我们首先构造3D-3D、3D-2D、2D-2D匹配,然后据此去估计相机的运动。完美估计需要完美的匹配,但实际的匹配中往往存在很多错误。如何消除或者降低错误匹配的影响呢?一种方法是选择那些正确的匹配进行估计(RANSAC),另一种是降低那些错误匹配的权重(鲁棒核函数),下面分别介绍。
1. RANSAC随机采样一致算法
这种方法的目的是,从所有数据中选择正确的数据,用于估计。为了方便,先给几个定义。
点: 每一个数据,SLAM里指的是匹配的点对 野值/外点: 错误的点 内点: 正确的点 内点集: 内点的集合 外点集: 外点的集合 模型: 带估计的参数 :估计模型所需要的最小点数 :所有的点形成的点集
显然,内点集就是我们想要找的正确数据。RANSAC的想法是从点集中随机的选择出 s s s
RANSAC 算法步骤:
从数据集中随机选择 s s s
计算所有点到模型的距离,得到内点集 I I I
如果 ∣ I ∣ > T |I|>T ∣ I ∣ > T
如果 ∣ I ∣ ≤ T |I|\leq T ∣ I ∣ ≤ T
经过 N N N
RANSAC里面有三个重要的参数需要确定,分别是 t t t T T T N N N
1.1 内点阈值 t t t
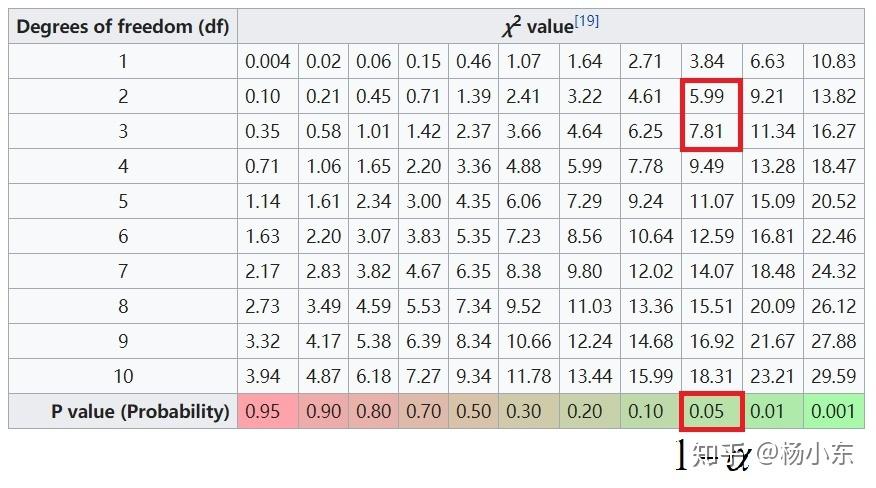
根据模型,每个点可以计算出一个距离的平方 d 2 d^2 d 2 t 2 t^2 t 2 d 2 d^2 d 2 m个独立标准正太分布的平方和服从m自由度的卡方分布 ,选择阈值 t t t α \alpha α
{ I n l i e r d 2 < t 2 O u t l i e r d 2 ⩾ t 2 , w h e r e , t 2 = F − 1 ( α ) σ 2 \left\{ {\begin{array}{l} {Inlier}&{{d^2} < {t^2}} \\ {Outlier}&{{d^2} \geqslant {t^2}} \end{array}, \ where,{t^2} = {F^{ - 1}}} \right.(\alpha ){\sigma ^2} \\ { I n l i er O u tl i er d 2 < t 2 d 2 ⩾ t 2 , w h er e , t 2 = F − 1 ( α ) σ 2 一般取 α = 95 % \alpha=95\% α = 95% t 2 t^2 t 2
1.2 采样次数 N N N
最多采样多少次就结束呢?一个点为内点的概率为 w w w ε = 1 − w \varepsilon = 1-w ε = 1 − w
事件A:在 次采样中,至少要有一次选取的子集 内没有外点的概率 。 事件A的逆事件为: 次采样中,所有选取的子集 内至少存在一个外点。这个概率为 。那么
N = l o g ( 1 − p ) l o g ( 1 − w s ) = l o g ( 1 − p ) l o g ( 1 − ( 1 − ε ) s ) ( 1 ) N= \frac{log(1-p)}{log(1-w^s)} =\frac{log(1-p)}{log(1-(1-\varepsilon)^s)} \ (1) \\ N = l o g ( 1 − w s ) l o g ( 1 − p ) = l o g ( 1 − ( 1 − ε ) s ) l o g ( 1 − p ) ( 1 ) 需要注意:
采样次数与内、外点的比例有关系,而与数据的量级无关系。 采样次数随着给最小点数 的增大而增大。
1.3 内点数量阈值T T T
当我们发现内点的数量足够多的时候就可以提前结束采样。内点数量的阈值 T T T ε \varepsilon ε n n n T = ( 1 − ε ) n T=(1-\varepsilon) n T = ( 1 − ε ) n
1.4 自适应的决定采样次数
从式(1)可以看出,采样次数 N N N w w w
开始时可以设 w = 0 w=0 w = 0 N = ∞ N=\infty N = ∞ n i n_i n i w = n i n w=\frac{n_i}{n} w = n n i N N N N N N
w = 0
sample_count = 0
while sample_count < N
    随机选取一个样本,并计算内点数 n_i
    if n_i 增加
        w = n_i / n
        根据 w 更新 N
    sample_count = sample_count + 1
end
1.5 实例-拟合2D直线
模型
直线的一般方程
A x + B y + C = 0 Ax+By+C=0 \\ A x + B y + C = 0 两边同时除以 C C C
A ∗ x + B ∗ y + 1 = 0 A^\ast x+B ^\ast y +1 = 0 \\ A ∗ x + B ∗ y + 1 = 0 两个点 ( X 1 , Y 1 , ) , ( X 2 , Y 2 ) (X_1, Y_1,), (X_2, Y_2) ( X 1 , Y 1 , ) , ( X 2 , Y 2 )
[ X 1 Y 1 X 2 Y 2 ] [ A ∗ B ∗ ] = [ − 1 − 1 ] \left[ {\begin{array}{c} {{X_1}}&{{Y_1}} \\ {{X_2}}&{{Y_2}} \end{array}} \right]\left[ {\begin{array}{c} {{A^ * }} \\ {{B^ * }} \end{array}} \right] = \left[ {\begin{array}{c} { - 1} \\ { - 1} \end{array}} \right]\\ [ X 1 X 2 Y 1 Y 2 ] [ A ∗ B ∗ ] = [ − 1 − 1 ] 可以解出来
[ A ∗ B ∗ ] = [ X 1 Y 1 X 2 Y 2 ] − 1 [ − 1 − 1 ] = 1 X 1 Y 2 − X 2 Y 1 [ Y 2 − Y 1 − X 2 X 1 ] [ − 1 − 1 ] = 1 X 1 Y 2 − X 2 Y 1 [ Y 1 − Y 2 X 2 − X 1 ] \begin{aligned}
\left[\begin{array}{c}A^*\\B^*\end{array}\right]
&= \left[\begin{array}{cc}X_1&Y_1\\X_2&Y_2\end{array}\right]^{-1}
\left[\begin{array}{c}-1\\-1\end{array}\right] \\
&= \frac{1}{X_1Y_2-X_2Y_1}
\left[\begin{array}{cc}Y_2&-Y_1\\-X_2&X_1\end{array}\right]
\left[\begin{array}{c}-1\\-1\end{array}\right] \\
&= \frac{1}{X_1Y_2-X_2Y_1}
\left[\begin{array}{c}Y_1-Y_2\\X_2-X_1\end{array}\right]
\end{aligned} [ A ∗ B ∗ ] = [ X 1 X 2 Y 1 Y 2 ] − 1 [ − 1 − 1 ] = X 1 Y 2 − X 2 Y 1 1 [ Y 2 − X 2 − Y 1 X 1 ] [ − 1 − 1 ] = X 1 Y 2 − X 2 Y 1 1 [ Y 1 − Y 2 X 2 − X 1 ] 注意到 A , B , C A,B,C A , B , C
A = Y 1 − Y 2 B = X 2 − X 1 C = X 1 Y 2 − X 2 Y 1 \begin{aligned}
A &= Y_1-Y_2 \\
B &= X_2-X_1 \\
C &= X_1Y_2-X_2Y_1
\end{aligned} A B C = Y 1 − Y 2 = X 2 − X 1 = X 1 Y 2 − X 2 Y 1 这就是两点确定一个条直线一般方程的方法。
内点距离
内点的距离取点到直线的距离
d 2 = ∥ A x + B y + C ∥ 2 A 2 + B 2 {d^2} = \frac{{{{\left\| {Ax + By + C} \right\|}^2}}}{{{A^2} + {B^2}}}\\ d 2 = A 2 + B 2 ∥ A x + B y + C ∥ 2 阈值 t 2 = 3.84 × σ 2 t^2=3.84 \times \sigma^2 t 2 = 3.84 × σ 2
代码
我们可以制造一些数据,来测试一下RANSAC。具体代码如下
ydsf16/MVG_Algorithm
2. 鲁棒核函数
上述RANSAC方法进行模型估计,实际上分了两步,首先选出局内点,然后再进行一步优化。鲁棒核函数只需要一步,直接优化求解模型参数,通过降低外点的权重,来降低错误数据的影响。一般,我们会优化如下的代价函数
a r g m i n ∑ i ∥ d i ∥ 2 argmin \sum\limits_i^{} {{{\left\| {{d_i}} \right\|}^2}} \\ a r g min i ∑ ∥ d i ∥ 2 外点造成的误差/距离 d i d_i d i d i d_i d i
arg min ∑ i ρ ( d i ) = { ∥ d i ∥ 2 , i f ∣ d i ∣ < t 2 t ∣ d i ∣ − t 2 , e l s e \arg \min \sum\limits_i^{} {\rho \left( {{d_i}} \right)} = \left\{ {\begin{array}{l} {{{\left\| {{d_i}} \right\|}^2},if\left| {{d_i}} \right| < t} \\ {2t\left| {{d_i}} \right| - {t^2},else} \end{array}} \right. \\ arg min i ∑ ρ ( d i ) = { ∥ d i ∥ 2 , i f ∣ d i ∣ < t 2 t ∣ d i ∣ − t 2 , e l se 当距离d i d_i d i d i d_i d i w i w_i w i
( w i d i ) T ( w i d i ) = ρ ( d i ) {\left( {{w_i}{d_i}} \right)^T}\left( {{w_i}{d_i}} \right) = \rho \left( {{d_i}} \right) \\ ( w i d i ) T ( w i d i ) = ρ ( d i ) 那么
w i = ρ ( d i ) ∥ d i ∥ {w_i} = \frac{{\sqrt {\rho \left( {{d_i}} \right)} }}{{\left\| {{d_i}} \right\|}} \\ w i = ∥ d i ∥ ρ ( d i ) 参考资料
[1] Multiple View Geometry
[2] g2o: A general Framework for (Hyper) Graph Optimization
----相关代码----
ydsf16 - Overview
----更多SLAM文章----
杨小东:[ORB-SLAM2] ORB-SLAM中的ORB特征(提取)
杨小东:SLAM轨迹真值获取装置
杨小东:[PnP]PnP问题之EPnP解法
杨小东:[PnP] PnP问题之DLT解法
杨小东:[ORB-SLAM2]卡方分布(Chi-squared)外点(outlier)剔除
杨小东:[ORB-SLAM2] ORB特征提取策略对ORB-SLAM2性能的影响
杨小东:[PR-3]ArUco EKF SLAM 扩展卡尔曼SLAM
杨小东:[PR-2] PF 粒子滤波/蒙特卡罗定位