NOTE / 2019/10/27
C++ 并发编程[Part 1]
在某些情况下,多线程可以大幅改善程序执行时间。如在SLAM中,通常有两个线程,一个线程用来实现高频率的里程计或定位,另一个线程用来进行低频的地图构建或者量测信息处理。这样大计算量的地图构建不会阻塞高频的定位输出。从C++11,标准库开始支持多线程编程。本文,对C++标准库中的多线程模块进行总结。本文内容摘抄自《C++标准库》。
1. 高级接口async和Futhure
假设,我们要计算下面四个函数的和。
在单线程中,会序列化的计算f(),总的运算时间就是这四个函数运算时间的总和+加法的运算时间。
但是,如果使用多线程技术,我们可以并行计算这四个函数,然后最后一起加起来,这样程序的耗时就是那个耗时最大函数的计算时间+加法的运算时间。例如这种的运算场景,多线程便可以大幅度提高运算效率。我们可以使用async启动一个线程,使用future,在未来获取线程返回的结果。程序如下:
#include <chrono>
#include <future>
#include <iostream>
#include <thread>

double function(const double var) {
    std::this_thread::sleep_for(std::chrono::milliseconds(1000));
    return var;
}

int main(int argc, char** agrv) {
    // Compute f1 + f2 + f3 + f4 using one thread.
    std::chrono::steady_clock::time_point t1 = std::chrono::steady_clock::now();

    double result = function(1.) + function(2.) + function(3.) + function(4.);

    std::chrono::steady_clock::time_point t2 = std::chrono::steady_clock::now();
    double time_cost = std::chrono::duration_cast<std::chrono::duration<double>>(t2 - t1).count() * 1000.;
    std::cout << std::fixed << "Sigal thread result: " << result << " and time cost: " << time_cost << std::endl;

    // Compute f1 + f2 + f3 + f4 using four threads.
    t1 = std::chrono::steady_clock::now();

    std::future<double> f1(std::async(std::launch::async, function, 1.));
    auto f2 = std::async(std::launch::async, function, 2.);
    auto f3 = std::async(std::launch::async, function, 3.);
    result = function(4.) + f1.get() + f2.get() + f3.get();

    t2 = std::chrono::steady_clock::now();
    time_cost = std::chrono::duration_cast<std::chrono::duration<double>>(t2 - t1).count() * 1000.;
    std::cout << std::fixed << "Multi-threads result: " << result << " and time cost: " << time_cost << std::endl;

    return 1;
}
结果如下:

可以看出,单线程处理时间几乎是多线程的4倍。
async和future、shared_future的具体使用方法请参考《C++标准库》
2. 线程同步与并发问题
在上述例子中,我们的四个线程之间都是独立进行的,并没有进行数据的交换。而在SLAM中,前端的定位线程与后端定位之间要进行地图的共享。在其他一些应用中,多线程之间的数据线程也是很常见的。
The only safe way to concurrently access the same data by multiple threads without synchronization is when ALL threads only READ the data
如果在多个线程之中对同一个数据进行读、写就会出现数据竞争问题。这种情况可以使用mutex和Lock解决。如下,我们对一个数据分别再两个线程中同时进行读写。
#include <chrono>
#include <iostream>
#include <mutex>
#include <random>
#include <thread>

double g_common_var = 0;
std::mutex g_common_var_mutex;

void Thread() {
    std::random_device rd;
    std::mt19937 gen(rd());
    std::uniform_real_distribution<> dis(0., 1000.);

    for (size_t i = 0; i < 100; ++i) {
        double random_common = dis(gen);
        {
            // or std::unique_lock<std::mutex> ul(g_common_var_mutex);
            std::lock_guard<std::mutex> lg(g_common_var_mutex);
            std::cout << std::fixed << "[Read] The common var in thread " << std::this_thread::get_id() << " is " << g_common_var << std::endl;
            g_common_var = random_common;
            std::cout << "[Write] The common var in thread " << std::this_thread::get_id() << " is " << g_common_var << std::endl << std::endl;
        }

        std::this_thread::sleep_for(std::chrono::milliseconds(500));
    }
}

int main(int argc, char** argv) {
    std::thread t1(Thread);
    std::thread t2(Thread);

    t1.join();
    t2.join();

    return 1;
}
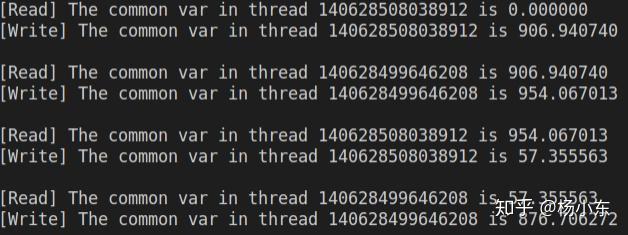
结果如下:
3. 数据生产与消费 - Condition variable
在SLAM中,我们经常由前端里程计部分挑选一些关键帧,发送给后端建图模块进行使用。也就是说1)关键帧在前端和后端线程中共享,2)在发送给后端的同时,我们还需要通知后端一声,让它开始处理数据。
这两项功能可以由condition variable实现,如下:
#include <atomic>
#include <chrono>
#include <condition_variable>
#include <iostream>
#include <queue>
#include <random>
#include <thread>
#include <mutex>
#include <memory>

class BackEnd {
public:
    BackEnd() {
        thread_ptr_ = std::make_unique<std::thread>(&BackEnd::Process, this);
    }

    void AddData(const int data) {
        {
            std::lock_guard<std::mutex> lg(data_queue_mutex_);
            data_queue_.push(data);
        }
        data_queue_cond_var_.notify_one();
    }

    void Process() {
        thread_running_.store(true);
        while (thread_running_.load()) {
            int data;
            {
                // Wait for data.
                std::unique_lock<std::mutex> ul(data_queue_mutex_);
                data_queue_cond_var_.wait(ul, [this]{ return !data_queue_.empty(); });
                data = data_queue_.front();
                data_queue_.pop();
            } // Release lock.

            // Process data.
            std::cout << "[BackEnd]: Recive data: " << data << std::endl << std::endl;
        }
    }

private:
    std::atomic<bool> thread_running_;

    std::mutex data_queue_mutex_;
    std::queue<int> data_queue_;
    std::condition_variable data_queue_cond_var_;

    std::unique_ptr<std::thread> thread_ptr_;
};

int main(int argc, char** argv) {
    // Start the back-end thread.
    BackEnd back_end;

    // This is the front-end.
    std::default_random_engine generator;
    std::uniform_int_distribution<int> distribution(0, 1000);
    for (size_t i = 0; i < 10; ++i) {
        // Produce data.
        int random_var = distribution(generator);

        // Send data to the back-end.
        back_end.AddData(random_var);

        std::cout << "[FrontEnd]: Add var " << random_var << std::endl;
        std::this_thread::sleep_for(std::chrono::milliseconds(500));
    }

    return 1;
}
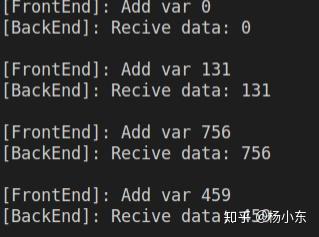
结果如下: